KI-Wissensmanagement
Private und lokale KI-Infrastruktur
KI on premise oder in einer privaten Cloud: Sprachmodelle laufen auf eurer eigenen oder kontrollierten Infrastruktur — damit sensible Daten das Haus nicht verlassen und ein LLM-Gateway steuert, welches Modell was zu sehen bekommt.
- 2
Schichten: Modell und Gateway
- 3
Betriebsvarianten
- 3
Nutzen: Datenschutz, Kontrolle, Kosten
Worum es geht
Das Fundament, nicht die Anwendung
Die anderen Bausteine — Wissensassistent, Automatisierung, Agenten — nutzen KI. Dieser hier stellt sie bereit und betreibt sie. Zwei Teile gehören dazu: lokal betriebene Sprachmodelle auf eurer Hardware, und ein Gateway als einziger kontrollierter Zugangspunkt vor allen Modellen.
Der Nutzen ist dreifach: Datenschutz, weil nichts ungewollt abfließt. Kontrolle, weil es einen prüfbaren Zugriffs- und Audit-Pfad gibt. Und Kostentransparenz, weil Modellwahl, Budgets und Limits an einer Stelle gesteuert werden — statt über viele unkontrollierte Direktzugänge zu Cloud-Diensten.
Am Markt begegnet euch das als „Private AI“, „Sovereign Cloud“, „AI Gateway“ oder „Managed Enterprise AI Stack“.
Aufbau
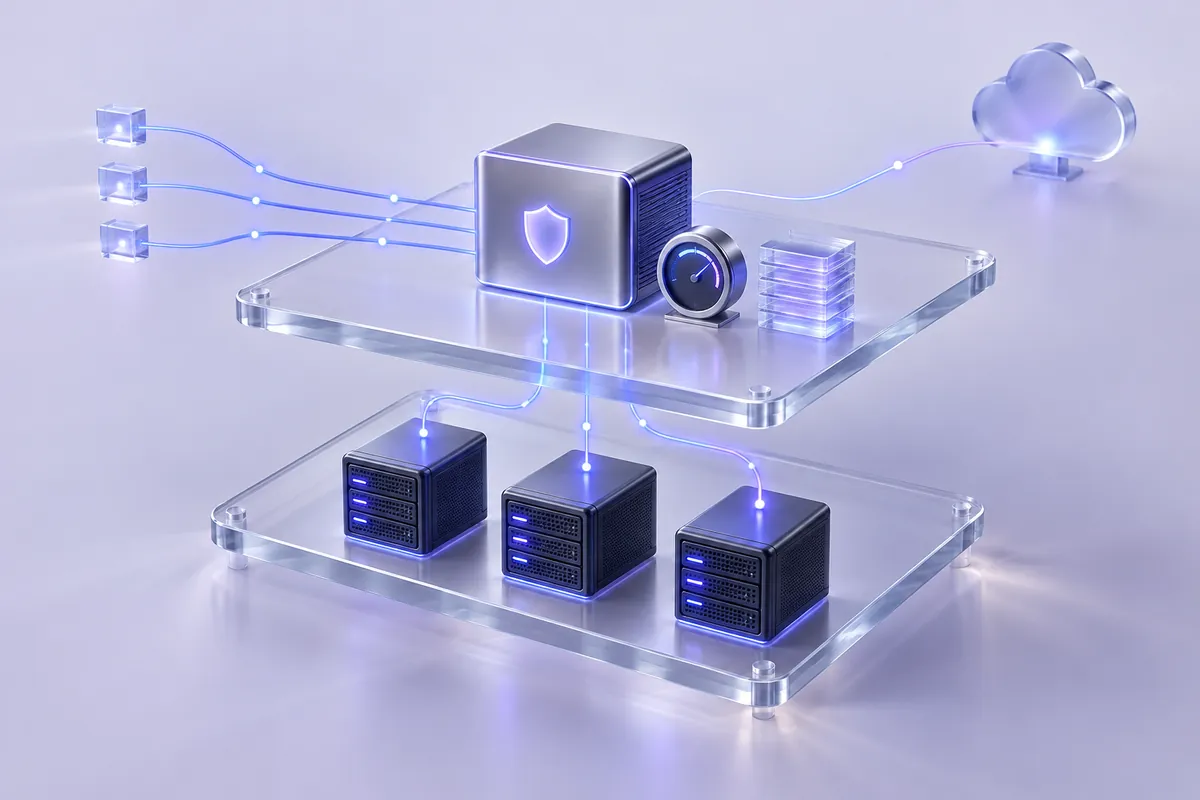
Zwei Schichten, die zusammenspielen
-
Modell- und Inferenzschicht
Offene Modelle laufen auf eurer Hardware — im Einstieg schlank containerisiert, im produktiven Betrieb über GPU-gestützte Inferenzserver mit Lastverteilung. Keine Cloud-Zugangsschlüssel, keine Datenweitergabe.
-
Gateway- und Kontrollschicht
Ein Gateway vereinheitlicht mehrere Modelle hinter einer Schnittstelle und übernimmt Routing, Rate-Limits, Budgetkontrolle, Caching und zentrale Protokollierung. Anwendungen wechseln zwischen lokalem und Cloud-Modell, ohne umgebaut zu werden.
Drei Betriebsvarianten, je nach Schutzbedarf:
- Vollständig On-Premises — eigene Hardware, maximale Datenhoheit.
- Private Cloud — dedizierte, DSGVO-konforme Umgebung ohne eigenen Serverraum.
- Hybrid — lokales Modell für Sensibles, Cloud-Modell für Unkritisches, gesteuert über das Gateway. In der Praxis der häufigste Zuschnitt.
Wann sinnvoll
Für wen sich der Aufwand lohnt
-
Sensible Inhalte
Personaldaten, Verträge, Kalkulationen, Patientendaten, Mandatsakten — überall dort, wo eine Weitergabe an Dritte nicht vertretbar oder nicht zulässig ist.
-
Regulierte Bereiche
Wo Nachweispflichten bestehen, ist ein zentraler Audit-Pfad kein Komfort, sondern Voraussetzung für den Einsatz überhaupt.
-
Hohes Nutzungsvolumen
Bei starker Nutzung kippt die Kostenrechnung gegenüber Cloud-Abrechnung pro Anfrage — allerdings nur mit ehrlicher Einrechnung von Hardware, Strom und Betrieb.
-
Mehrere KI-Anwendungen
Sobald Wissensassistent, Automatisierung und Agenten parallel laufen, ist ein gemeinsamer Zugangspunkt wartbarer als getrennte Zugänge je Anwendung.
Ehrlich gesagt
Was hier regelmäßig schiefgeht
- Hardware wird zu knapp dimensioniert. Ohne passende GPU-Ausstattung leiden Antwortzeit und Qualität. Und kleinere lokale Modelle sind schwächer als große Cloud-Modelle — wer das Gegenteil verspricht, verkauft eine Enttäuschung.
- Betrieb wird als Einmal-Setup gedacht. Updates, Monitoring, Skalierung, Ausfallsicherheit und Modellpflege sind Dauerlast. Ohne Betriebskonzept verfällt der Stack innerhalb eines Jahres.
- Das Gateway ist auch ein Ausfallpunkt. Es bündelt die Governance — und damit das Risiko. Absicherung, Rechte, Limits und Audit-Logging gehören von Anfang an dazu, nicht nachträglich.
- „Lokal“ wird falsch verstanden. Der Schutz greift nur, wenn nicht doch sensible Inhalte über das Gateway an Cloud-Modelle geroutet werden. Die Routing-Regeln müssen explizit festgelegt und überprüft werden.
- Zugänge werden unzureichend gesichert. Offene Endpunkte oder schlecht verwaltete Zugangsdaten heben den gesamten Datenschutzvorteil auf.
- Die Kostenrechnung wird geschönt. Cloud wirkt anfangs günstiger; Self-Hosting rechnet sich erst ab einem gewissen Volumen — und nur mit vollständiger Kostenbetrachtung.
Vorgehen
Wie wir anfangen
- Einstiegs-Setup ein lokaler Stack mit einem Modell für ein Team, containerisiert aufgesetzt. Damit lässt sich realistisch beurteilen, ob Qualität und Antwortzeit für euren Anwendungsfall reichen.
- Gateway-Einführung mehrere Modelle hinter einem Zugangspunkt, mit Rechten, Budgets und Protokollierung.
- Skalierter Betrieb GPU-Inferenz mit Lastverteilung, Ausfallsicherheit, Sicherheits- und Auditkonzept.
Wichtig ist die saubere Trennung von einmaligem Aufbau und dauerhaftem Betrieb — Letzterer ist der Teil, der über Jahre trägt. Rahmen dazu unter Preise.
Leistungssäule
Mehr aus KI-Wissensmanagement
KI-Wissensmanagement
Interne Wissenssysteme, RAG, Assistenten und die nötige Infrastruktur für belastbare Antworten.
Mehr erfahren →
Interner KI-Assistent auf Firmenwissen
Ein internes GPT/RAG-System mit Quellenangaben auf Basis eurer eigenen Unterlagen.
Mehr erfahren →Betriebsvarianten
KI on premise, private Cloud oder hybrid im Vergleich
Drei Zuschnitte für private KI — sie unterscheiden sich darin, wo die Modelle laufen und wer den Betrieb trägt.
| Variante | Wo die Modelle laufen | Datenhoheit | Passt, wenn … | Zu beachten |
|---|---|---|---|---|
| On premise | auf eigener Hardware im eigenen Haus | vollständig bei euch | Inhalte sensibel sind, Nachweispflichten bestehen oder die Nutzung hoch ist | Hardware mit passender GPU, Strom, Updates und Betrieb liegen bei euch |
| Private Cloud | in einer dedizierten Umgebung bei einem Anbieter | vertraglich geregelt, getrennt von anderen Kunden | Schutz nötig ist, aber kein eigener Serverraum | Wahl von Anbieter und Standort |
| Hybrid | lokal für Sensibles, Cloud-Modell für Unkritisches | je nach Routing-Regel | mehrere Anwendungen mit unterschiedlichem Schutzbedarf laufen | Routing-Regeln müssen festgelegt und geprüft werden |
In der Praxis ist der hybride Zuschnitt der häufigste. Entscheidend ist das LLM-Gateway davor: Es legt fest, welche Anfrage an welches Modell gehen darf.
Einordnung
Warum Datenhoheit bei KI den Ausschlag gibt
Datenschutz ist unter KI-Nutzern das meistgenannte Hemmnis. Wer sensible Inhalte verarbeitet, entscheidet deshalb zuerst über den Betriebsort — und erst dann über die Anwendung.
- 66 %
der KI-Nutzer nennen Anforderungen an den Datenschutz als Hemmnis.
- 45 %
sorgen sich, dass Unternehmensdaten in falsche Hände gelangen.
- 51 %
nennen die Infrastruktur (Cloud, Rechenleistung) als großen Kostenpunkt.
- 8 %
sehen dagegen den Token-Verbrauch als großen Kostenpunkt.
Quelle: Bitkom-Umfrage unter 603 Unternehmen ab 20 Beschäftigten, durchgeführt von Bitkom Research, veröffentlicht am 14. September 2026.
Häufige Fragen
Häufige Fragen zu KI on premise
Was bedeutet KI on premise?
KI on premise heißt: Die Sprachmodelle laufen auf eurer eigenen Hardware statt bei einem Cloud-Dienst. Anfragen und Dokumente verlassen das Haus nicht, und es gibt keine Zugangsschlüssel zu externen Diensten, über die Daten abfließen könnten.
Was ist ein LLM-Gateway?
Ein Gateway ist der einzige kontrollierte Zugangspunkt vor allen Modellen. Es vereinheitlicht mehrere lokale und Cloud-Modelle hinter einer Schnittstelle und übernimmt Routing, Rate-Limits, Budgets, Caching und zentrale Protokollierung — so wechseln Anwendungen das Modell, ohne umgebaut zu werden.
Sind lokale Modelle so gut wie Cloud-Modelle?
Nicht immer. Kleinere lokale Modelle sind schwächer als die großen Cloud-Modelle. Deshalb beginnt es mit einem Einstiegs-Setup, an dem sich realistisch prüfen lässt, ob Qualität und Antwortzeit für euren Anwendungsfall reichen.
Welche Hardware braucht lokale KI?
Das hängt von Modellgröße, Nutzerzahl und gewünschter Antwortzeit ab. Für den Einstieg reicht ein containerisierter Stack für ein Team; produktiv laufen GPU-gestützte Inferenzserver mit Lastverteilung. Zu knapp dimensionierte Hardware ist einer der häufigsten Fehler.
Ist KI on premise günstiger als die Cloud?
Erst ab einem gewissen Nutzungsvolumen — und nur, wenn Hardware, Strom und Betrieb ehrlich eingerechnet werden. Cloud wirkt anfangs günstiger; die Rechnung machen wir vor der Entscheidung gemeinsam.
Was kostet der Einstieg in private KI-Infrastruktur?
Der Einstieg ist der kostenlose Check (45–90 Minuten). Der KI-Audit liegt ab 2.500 €, ein Pilot für einen abgegrenzten Anwendungsfall bei 5.000 bis 15.000 €, der laufende Betrieb beginnt ab 750 € im Monat. Hardware- oder Cloud-Kosten fallen zusätzlich direkt bei euch an. Alle Stufen und die laufenden Kosten stehen unter Preise.
Müssen eure Daten im Haus bleiben?
Dann klären wir zuerst, welcher Zuschnitt reicht — vollständig lokal, private Cloud oder hybrid. Ohne Hardware zu verkaufen, die ihr nicht braucht.